documentador: toda mi documentación personal en un binario Go y un SQLite
Actualizado en octubre de 2026: documentador ya habla con Claude por MCP y tiene app para iPhone y iPad. Lo cuento en «Conectado a Claude por MCP» y «En el bolsillo».
Llevaba tiempo queriendo un sitio único para mi documentación personal: notas técnicas, chuletas, procedimientos que siempre acabo rebuscando. Los requisitos eran claros: local, sin suscripciones, sin sincronizaciones mágicas, y con una prueba de fuego muy concreta — poder llevármelo todo a otra máquina copiando dos ficheros.
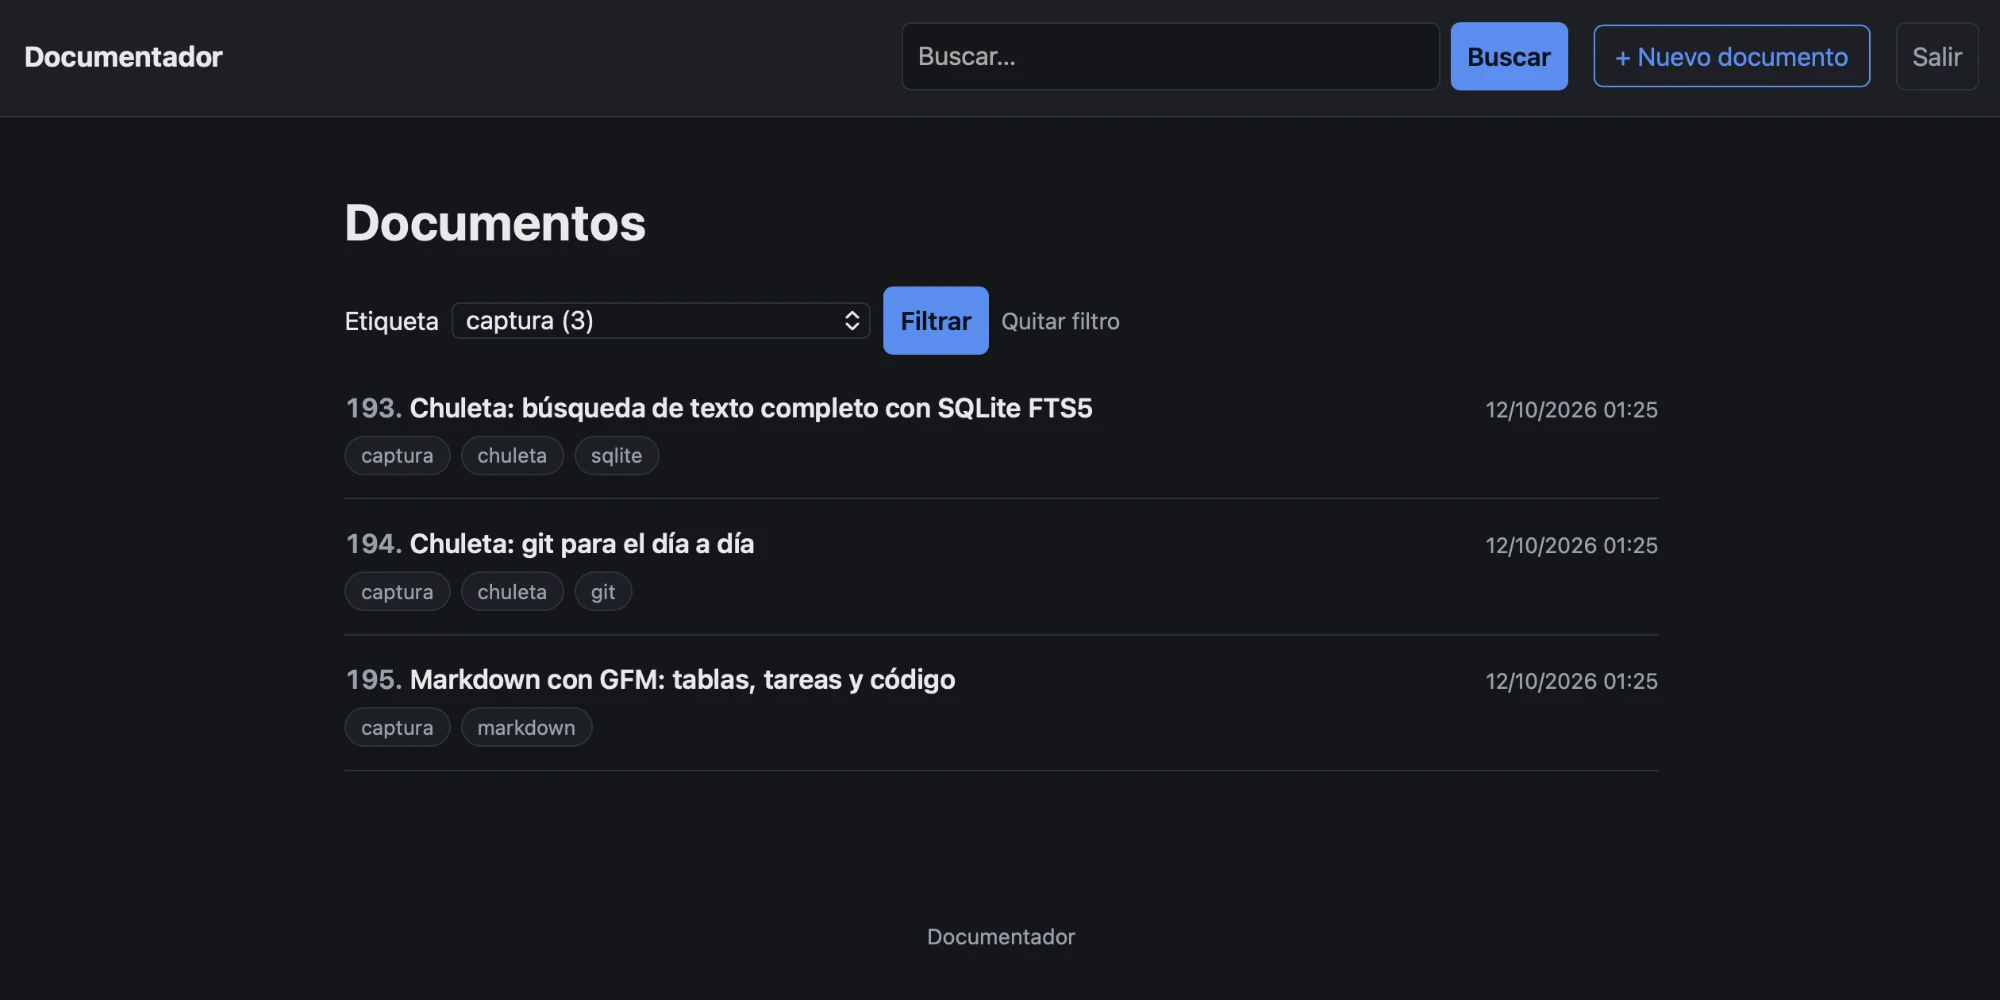
De ahí salió documentador: una sola aplicación escrita en Go que hace de CLI, de servidor web y de API, con todo el estado en un único fichero SQLite. Binario + base de datos = instalación completa.
Una app, cuatro puertas
- CLI para el día a día: crear, buscar, editar y etiquetar documentos desde la terminal, con salida
--jsonpara automatizar. - Web embebida en el propio binario: lista con búsqueda, render de Markdown, modo claro/oscuro, y usable desde el móvil.
- API JSON para trabajar en remoto: los mismos documentos, desde cualquier sitio, con tokens revocables.
- Servidor MCP para Claude: la app de Claude y Claude Code buscan, leen y escriben en la documentación como si fuera una herramienta más (más abajo, en «Conectado a Claude por MCP»).
Los documentos se escriben en Markdown y la búsqueda es de texto completo (FTS5 de SQLite), con fragmentos resaltados. Lo que no es texto —imágenes, PDFs— también vive dentro de la base de datos, como adjuntos: la portabilidad no admite excepciones.
El stack, deliberadamente aburrido
| Pieza | Elección | Por qué |
|---|---|---|
| Base de datos | SQLite en Go puro (sin CGO) | compila a binario único y cruza-compila a cualquier plataforma |
| CLI | cobra | subcomandos y flags estándar |
| Markdown | goldmark + GFM | tablas, tachado, autolinks |
| Web | net/http + html/template + embed | cero frameworks, todo dentro del binario |
Protegido por defecto
En cuanto defines una contraseña, la web exige sesión y la API exige token Bearer. Y hay un detalle del que estoy especialmente contento: el servidor se niega a escuchar fuera de localhost si no hay autenticación configurada. Es imposible exponerlo abierto a internet por descuido; tienes que pedirlo explícitamente con un flag que deja claro lo que estás asumiendo.
Para compartir algo puntual sin dar acceso a nada más, cada documento puede generar un enlace público de solo lectura: una URL con un token aleatorio de 128 bits, revocable al instante, que muestra ese documento (y solo ese) sin login y con noindex para los buscadores.
Desplegarlo donde quieras
Para servirlo desde un servidor hay una imagen Docker construida from scratch: unos 14 MB que contienen solo el binario, corriendo sin root, con los datos en un volumen. La primera arrancada obliga a definir la contraseña; después, actualizar la versión nunca toca los datos.
docker volume create documentador-data
echo 'mi-clave' | docker run -i --rm -v documentador-data:/data \
    documentador auth set-password --password-stdin
docker run -d -p 8080:8080 -v documentador-data:/data documentador
Conectado a Claude por MCP
Desde la versión 0.4 el mismo binario expone también un servidor MCP (Model Context Protocol). Con él, documentador aparece como conector personalizado en la app de Claude —web, escritorio y móvil— y en Claude Code. En la práctica: le pregunto a Claude «¿qué tengo apuntado sobre…?» y busca en mi documentación; le pido que documente lo que acabamos de hacer y lo escribe ahí. Los agentes que trabajan conmigo dejan en documentador sus planes y sus traspasos de trabajo, y el siguiente agente los lee de ahí.
Tres decisiones de diseño me llevaron más tiempo que el código:
- El token va en la URL. Los conectores personalizados de la app de Claude solo admiten OAuth o «sin autenticación»: no hay forma de mandar una cabecera
Bearerfija. Así que el conector se declara sin autenticación y la seguridad está en la propia URL, que lleva un token revocable (una capability URL). Uso un token dedicado solo para el conector, porque una URL puede acabar en algún log intermedio, y así puedo revocarlo sin tocar nada más. - Token incorrecto, 404; nunca 401. Un 401 hace que el cliente arranque un flujo OAuth que aquí no existe. Un 404 dice simplemente «aquí no hay nada», que además es lo que debe ver quien prueba URLs al azar.
- HTTP sin estado y solo JSON, sin SSE. Cada petición se sostiene sola, así que sobrevive a un redespliegue a mitad de conversación y a proxies que almacenan las respuestas en búfer.
El servidor ofrece diez herramientas, con las mismas formas JSON que la API: listar, leer, crear, editar, borrar y buscar documentos, listar etiquetas, y crear, consultar y revocar enlaces públicos. Darlo de alta en Claude Code es una línea:
claude mcp add --transport http documentador https://tu-servidor/mcp/<token>Lo que no viaja por MCP: los adjuntos
Ninguna de las diez herramientas sube o baja ficheros, y no es un descuido: por MCP es impracticable. Los argumentos de una herramienta los genera el modelo token a token, así que subir un PNG de 150 KB le obligaría a escribir unos 200 KB de base64, cerca de 50.000 tokens, sin equivocarse en uno solo. Los bytes van por un canal de bytes —la API REST, con un multipart normal— y por MCP viaja solo la referencia al adjunto. La excepción son los artefactos que ya son texto, como un diagrama en SVG o Mermaid: esos el modelo los escribe directamente.
El siguiente paso que tengo apuntado son permisos por token, por ejemplo uno de solo lectura para conectores en los que confío menos.
En el bolsillo: DocuReader para iPhone y iPad
La web embebida funciona en el móvil, pero para consultar una chuleta de pie, en un pasillo o en una sala de máquinas, quería algo nativo. DocuReader es una app en SwiftUI para iPhone y iPad que habla con la misma API JSON. Es de solo lectura a propósito: escribir sigue siendo cosa del ordenador o de Claude.
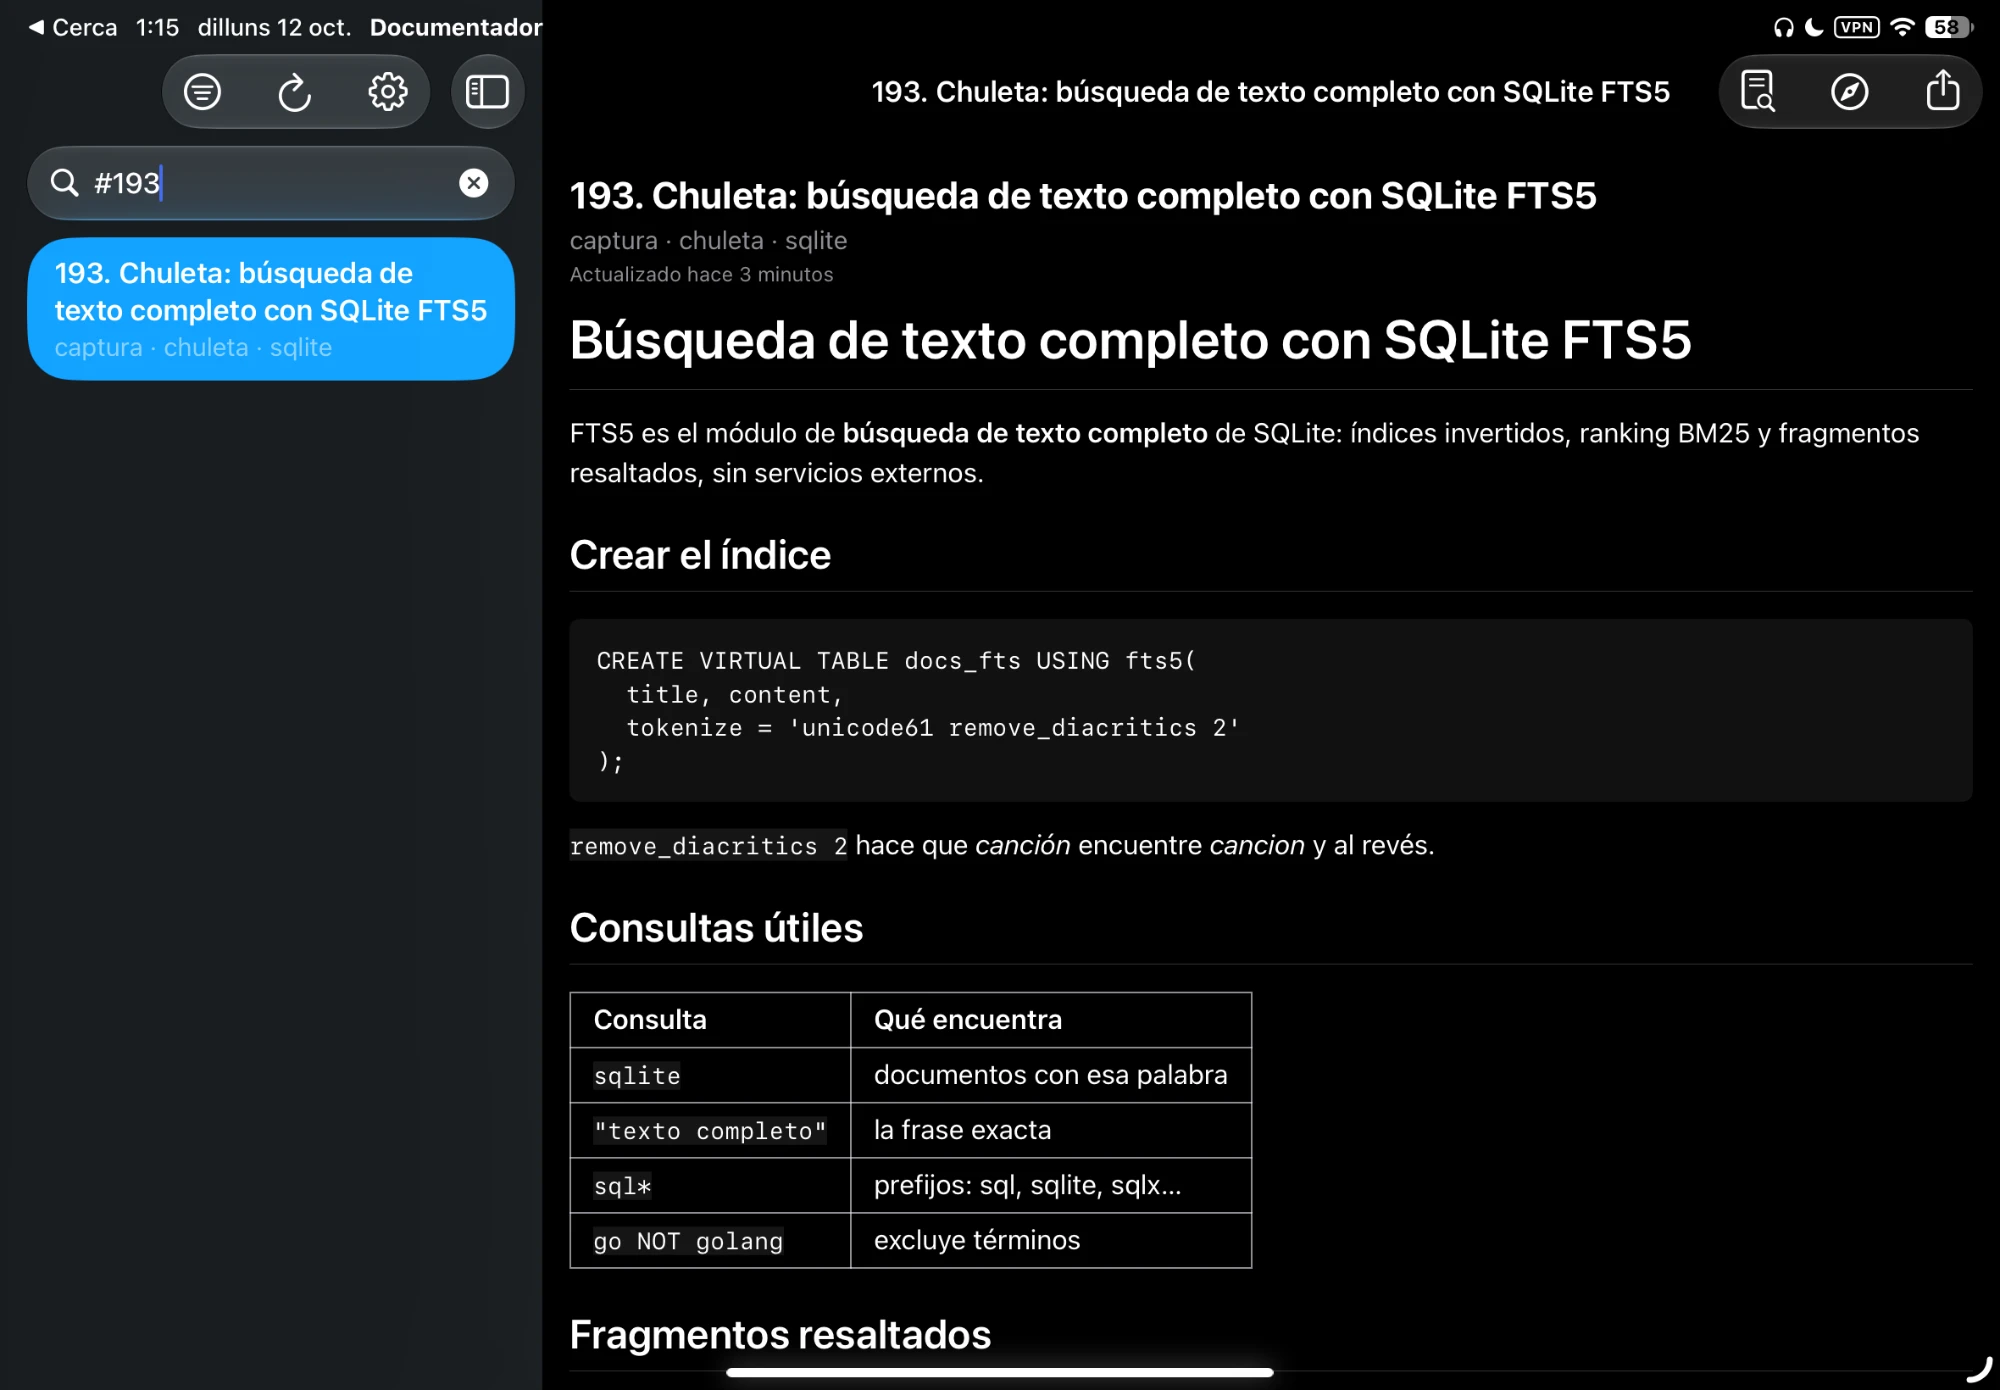
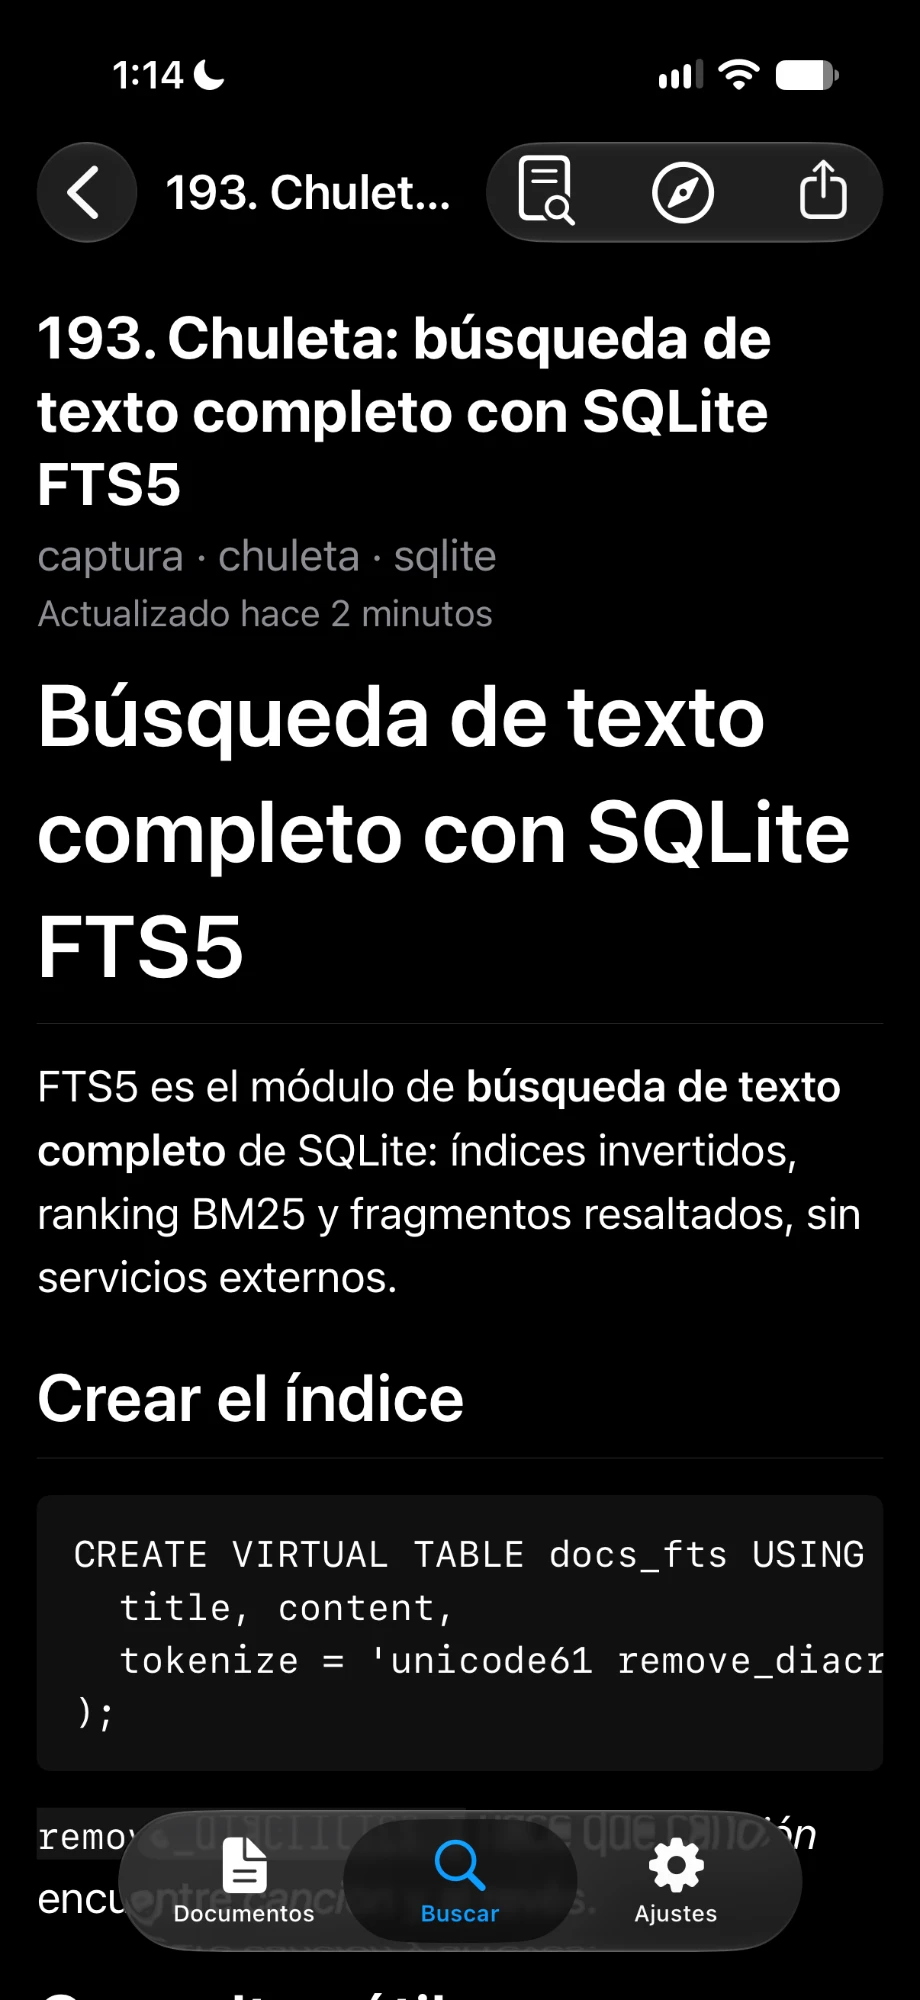
- Lista y búsqueda: los documentos con sus etiquetas y la fecha relativa («hace 2 meses»), filtro por etiqueta, y la búsqueda de texto completo del servidor con el término encontrado en negrita.
- Lectura nativa: Markdown con tablas y código, modo oscuro, texto seleccionable, imágenes adjuntas, el resto de adjuntos con la vista previa del sistema, y los enlaces entre documentos se abren dentro de la app.
- iPad: lista o resultados a la izquierda y el documento a la derecha; en Slide Over o en una mitad estrecha vuelve al diseño del iPhone sin perder la búsqueda ni el filtro.
- Token en el Llavero: nunca en el código ni en los ajustes. Si lo revoco en el servidor, la app lo detecta, lo borra y vuelve a la pantalla de configuración.
Está hecha con el mismo método que el servidor —especificación primero, tests después— y tiene 132 tests. No está en la App Store: la instalo en mis dispositivos directamente desde Xcode. Si te pica la curiosidad de cómo se reparte una app así sin tienda, lo conté en cómo instalar una app iOS sin App Store ni TestFlight.
Lo más interesante: cómo se construyó
El proyecto entero está desarrollado con una metodología que combina tres cosas: SDD (Spec-Driven Development: las especificaciones son el contrato, y nada se implementa sin spec), TDD (el test en rojo antes que el código) y orquestación de agentes de IA — una sesión principal que diseña y verifica, delegando la implementación en subagentes que trabajan por fases, cada uno con propiedad exclusiva de sus ficheros.
El resultado: unos 185 tests, cero regresiones entre fases, y una lección que me llevo — una spec detallada convierte a un modelo de IA medio en un implementador sorprendentemente fiable. El gasto en especificar se recupera multiplicado.
Los tests prueban unidades; el orquestador prueba la historia completa. Lo que ninguno de los dos ve —un CSS que se rompe a 390 píxeles, un proxy que cachea ocho días— lo encuentra la verificación con el sistema de verdad.
El detalle de la metodología —specs, fases, prompts de subagentes y trucos para no quemar contexto— acabó siendo un tutorial entero: iadev, diez capítulos para programar con IA sin que la IA decida por ti. Y si te interesa cómo enseñarle herramientas a Claude o cómo hacer que varios agentes se hablen, sigue en Anatomía de un skill y en Correo entre agentes de IA.